网上常见一种“AI 工作流”:把写文案拆成策划 Agent → 写作 Agent → 润色 Agent → 审核 Agent,像一个人指挥一个团队,很有掌控感。
我最初也想过用 OpenClaw 调度 Codex、Claude Code 和 Grok 组成协作团队,后来放弃了。下面说为什么,以及 OpenClaw 最后实际在干什么。
多 Agent 贵在哪
启动一个子 Agent,要给它注入足够的上下文,每个 Agent 都要重新加载指令,执行完还要把结果汇总回主 Agent。这些都是固定开销,任务拆得越碎,重复注入上下文的比例就越高。5 个 Agent 重复读取项目上下文、互相解释、交接、总结与反思,大部分 Token 都花在这上面。
我的做法是先把单 Agent 配合工具(Tools)用顺手,再考虑拆分。简单、可组合的工作流,通常比复杂的 Agent 框架更可靠。
拆分也有划算的时候:任务能真正并行。比如同时检索十份资料,子 Agent 各查各的,互不干扰,最后只汇总结论,主会话的上下文也不会越滚越大。
判断标准只有一条:拆开之后,每个子任务是否真的独立,有没有各自独立的上下文需求。如果大家看的还是同一份材料、做的还是同一件事,单 Agent 直接处理更划算。
OpenClaw 最终干了些什么
案例一:服务监控
我的服务器只有 2G 内存,部署着两个 Java 服务和一个静态博客,装不下 Uptime Kuma 这类监控面板。
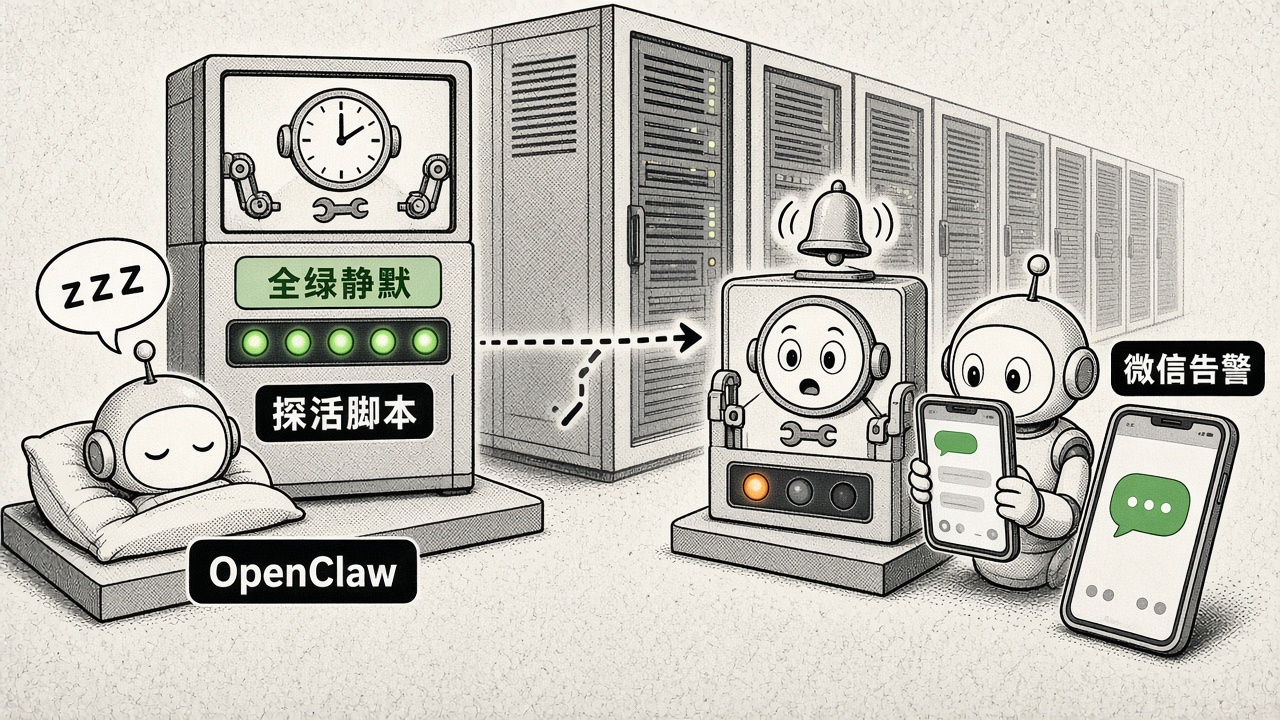
一个探活脚本每十分钟访问三个公网地址,全绿就静默,有服务挂了就以退出码 1 结束。探到异常时,OpenClaw 才被唤醒:自动 SSH 登录服务器执行 systemctl status 和 journalctl,把故障服务、可能原因和排查建议发到微信。
监控的采集由脚本完成,AI 只负责收到告警后判断该查什么、怎么解释。平时零 Token 消耗,出故障才动用模型,响应也更快。
案例二:部署交给 CI
博客是 Astro 静态站。以前发文章要手动 SSH 上传,现在改用 GitHub Actions:推送代码到 main 分支后,自动构建、SSH 上传,并原子切换服务器目录。构建成功就上线,失败就报错,没有模糊空间。
这一步我没有让任何 Agent 参与。部署规则明确,结果也容易验证,交给确定性工具比交给模型可靠。AI 只在构建失败时帮忙读日志、定位原因。
案例三:写作,AI 整理,我来定
写作这块我让 AI 参与得多一些,边界还是明确的。日常记录随手追加到日志文件里(成本极低),只有我明确要整理成文时,AI 才把零散日志提炼成结构化草稿。写作由我主导,AI 只把碎片素材梳理成提纲。
链条是这样:想到内容随手记下来 → 定期由 AI 整理成草稿 → 我在编辑器里打磨 → 推送代码后自动上线。
我最后收敛成的样子
不再让几个角色互相开会,OpenClaw 只承担明确的职责:
- 总控:接收告警、收集信息、决定下一步调用哪个工具。
- 修复简单代码:只有代码明确需要调整时才唤起,改完即退出。
- 分析问题:读取日志、总结错误、判断问题原因。
最稳定、最确定的工作,依然交给传统工具:部署交给 CI,监控采集交给探活脚本,模型只管决策和解读。
现在的状态
想到想法随手记下,要发博客时几分钟就能整理好,代码推送后自动部署上线。AI 负责记录、整理、改写和分析,不控制整个系统。
我至今没配 CEO Agent,也没堆十几个角色。那些更像形式表演,我要的是能把一件具体的事稳定做完的系统。